
AI 推荐
Ollama 本地部署开源模型:显存、量化与上手步骤
有个做跨境工具的朋友算了笔账:他要批量处理一批合同和客户沟通记录,走云 API 按 token 算下来一个月是一笔不小的开销,而且这些内容他根本不想往外发。纠结了两周,他最后把几个开源模型拉到自己机器上,用 Ollama 跑了起来。这是本地部署最典型的动机——在意隐私、又在意长期成本。
 AI 操作示意图·以官网实际界面为准
但真上手之前,有两道坎绕不开:显存够不够、量化值不值。
1. 什么人适合本地跑
| 你的情况 | 更建议 |
|---|---|
| 偶尔问答、量不大 | 云 API 更省心,别折腾硬件 |
| 要批量处理敏感内容、不想出本地 | 本地部署更合适 |
| 长期高频调用、预算敏感 | 本地一次性硬件投入可能更划算 |
| 想玩模型、调参、二次开发 | 本地部署自由度最高 |
一句话:本地部署不是"更高级",而是"更自主"。你的需求里只要沾着隐私或长期成本这两样,它才值得投入。
2. 显存:先算清硬件这道坎
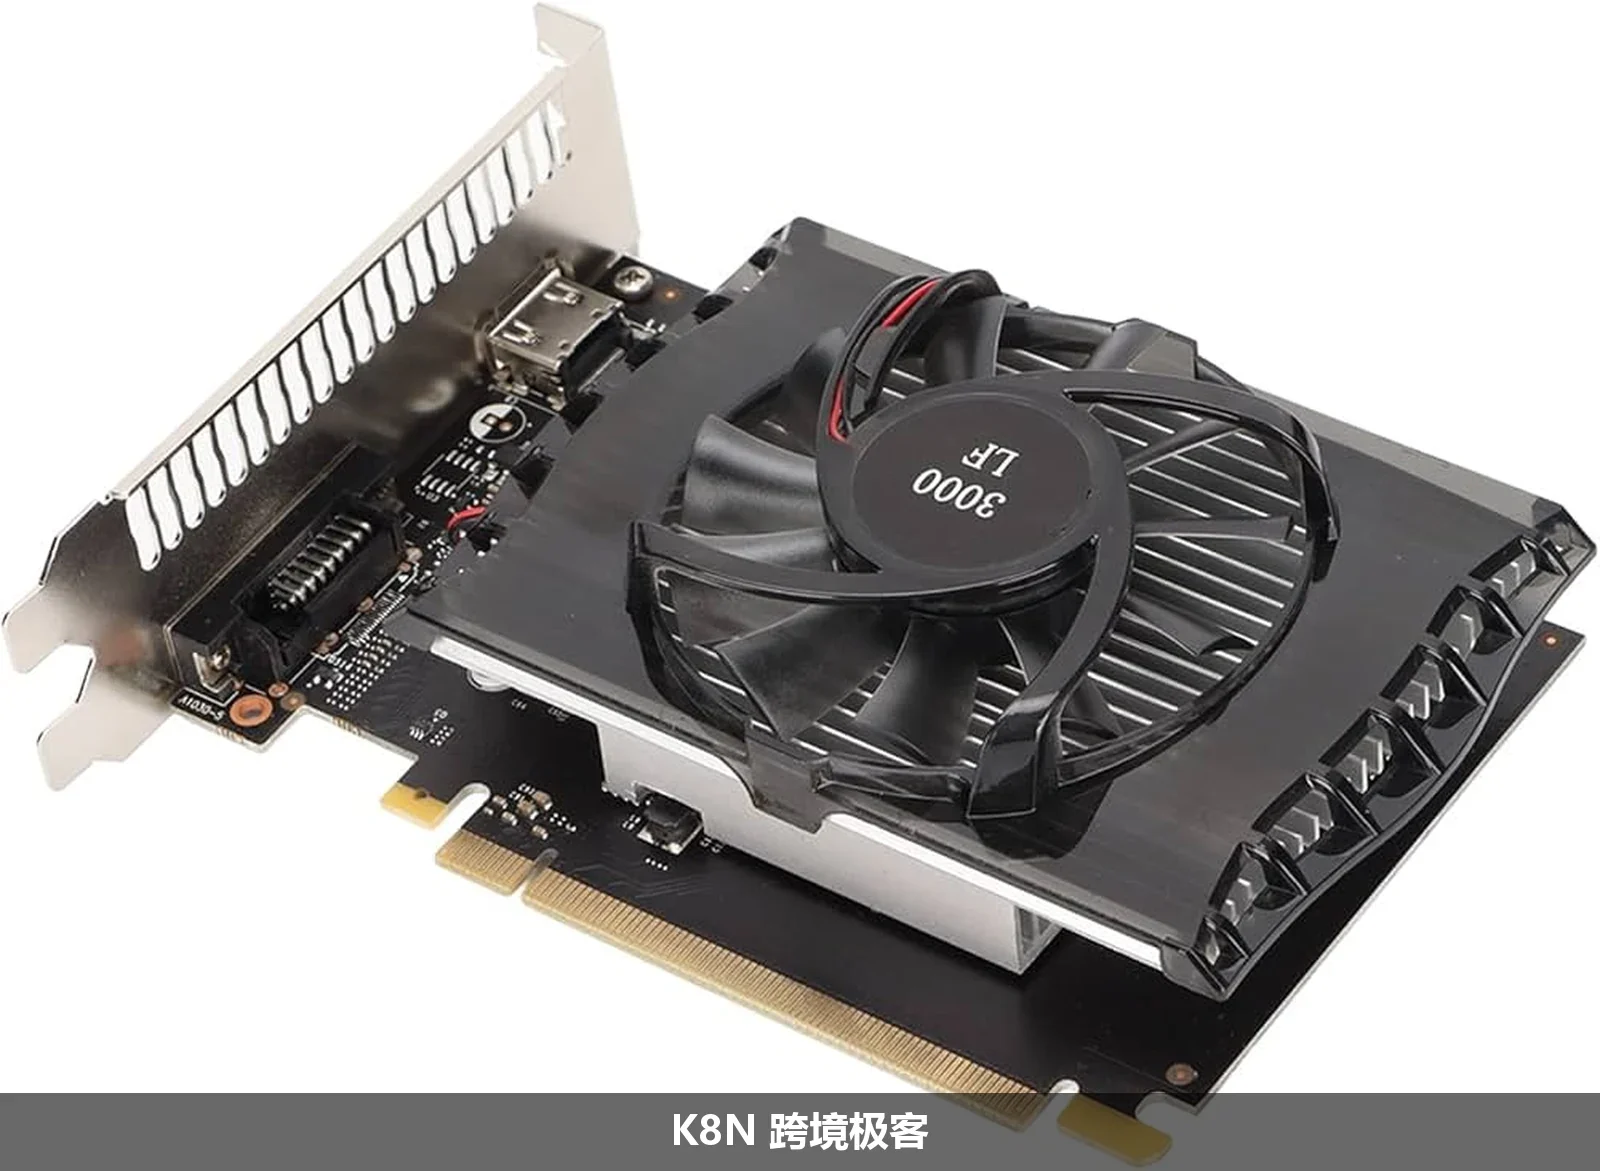
跑模型最现实的门槛就是显存。同一个模型,参数量越大,加载时占用的显存和内存就越高;显存吃紧时,模型要么加载不起来,要么被迫往内存里换页,速度掉到难以接受。
 AI 操作示意图·以官网实际界面为准
所以动手前先看两件事:自己显卡的显存多大、打算跑的模型官方建议配置是多少。别上来就下最大的模型——"能不能跑起来"和"跑起来卡不卡"是两回事,后者往往才是劝退的开始。
3. 量化:降门槛,但要接受取舍
模型提供不同的量化版本,本质是用更低的精度来压缩体积。量化之后,同样的显卡能跑下更大的模型,门槛一下就降下来了。
代价是精度和效果会有取舍:数值精度压得越低,体积越小、跑得越快,但生成质量和细节也会打折扣。我的建议是——先用能跑起来的量化版本跑通流程,确认这个模型对你的任务真的够用,再决定要不要为了更好的效果上更重的版本。
4. 上手大致怎么走
具体命令随版本会变,这里只说大方向,每一步都以官方文档当前页面为准:
- 到 Ollama 官网下载对应系统的安装包,装好命令行工具;
- 在模型库里挑一个你想跑的模型,按官方给出的命令拉取并运行;
- 首次运行会自动下载模型文件,等下载完成后就能在本地对话;
- 显存不够时,换一个更小的量化版本重试,而不是硬扛。
5. 怎么判断值不值
别把本地部署当目的。我见过太多人折腾一晚上把模型跑起来,新鲜两天就不再打开。更稳的做法是:先用云服务把真实场景跑通、确认用量和敏感度,再倒推"本地部署到底能省多少、值多少硬件投入"。算清楚这笔账,再决定要不要动手。
没有大显存显卡能不能跑?
可以从很小的量化模型试起,但体验会明显受限。显存不足时优先换小模型,而不是指望大模型"凑合跑"。
本地跑是不是就完全不用联网?
模型运行本身在本地,但首次下载模型、更新工具、部分联网功能仍需网络;具体能力以官方文档为准。
官方资料
资料核对日期:2026-10-23。以下链接均为官方页面,发布前已核对可访问:
- Ollama 官网(下载与模型库入口):https://ollama.com/
- Ollama GitHub 开源仓库(文档与 issue 入口,以官网实际链接为准)
本文为本地部署思路梳理,不构成购买建议;显存建议、量化格式与命令参数以 Ollama 官方文档当前页面为准。
最近一周热门文章
按近 7 天访问热度排序,热度积累前优先展示新文章。






当前栏目最新文章
AI 推荐 · 继续阅读同栏目的新内容
一起交流
0 条留言LEAVE A NOTE
你的经验,也很重要。
无需注册或登录。请勿公开邮箱密码、证件、银行卡号或其他敏感信息。





还没有留言,来分享你的想法吧。