
AI 推荐
本地部署大模型入门:Ollama 之外还有哪些工具,硬件怎么配
有读者问:"我看了站内那篇 Ollama 上手教程,跑通了一个 7B 模型,但最近想跑更大的、还听说有 vLLM、llama.cpp 这些名字,到底什么时候该换工具?我这张老显卡还能不能继续扛?"这问题挺实在——Ollama 把入门门槛压得很低,但"想再往前走一步"的时候,工具全景和硬件怎么配就绕不开了。本篇不重复 Ollama 的上手步骤,专门讲工具全景与硬件选型。
 AI 操作示意图·以官网实际界面为准
1. 先分清:四类本地工具的定位不一样
很多人把"本地跑模型"理解成一个软件,但实际上它们干的是四件事:
- Ollama:一键拉模型、一键起服务,适合"我今天就想在本机聊天"的入门用户。
- llama.cpp:C/C++ 实现的推理引擎,CPU 也能跑,Apple Silicon 是一等公民,量化档位非常全,适合"没有好显卡、想榨干笔记本"的人。
- LM Studio:带图形界面的本地模型管理器,底层也是 llama.cpp / MLX,适合"不想敲命令、想点鼠标下载模型"的人。
- vLLM:高吞吐服务端推理框架,主打并发、PagedAttention、连续批处理,适合"我要把本地模型当 API 给多人用"的人。
一句话:Ollama/LM Studio 是给个人用的,llama.cpp 是引擎,vLLM 是给服务端用的。入门用 Ollama 或 LM Studio 都不会错;等你想"在 CPU 上凑合跑"再试 llama.cpp;等你想"起个本地 API 给应用调用、还要多人并发"再上 vLLM。
2. 显存怎么估算:给一个思路公式,不给死数字
我到底要多大显存才能跑多大模型?
记住一个粗算思路:模型参数量(B)× 每参数字节数 ÷ 1024 ≈ 需要的显存(GB)。量化档位越低,每参数字节数越小,但效果也会损失。4-bit 量化大概是每参数 0.5–0.6 字节,8-bit 大概 1 字节,FP16 大概 2 字节。再额外留 20%–30% 给上下文和 KV 缓存。这只是粗算,真实占用还和上下文长度、是否用 GQA 有关。
举个简化的例子:一个 7B 模型走 4-bit 量化,光模型权重就大约 4–5GB;再加上下文和 KV 缓存,6–8GB 显存比较稳。一个 70B 模型走 4-bit,光权重就要 35–40GB 左右——这就是为什么"想跑 70B"基本得双卡或者上 Mac 大内存。
关键不是背数字,而是反过来推:先想清楚"我日常要用多大的模型、多长的上下文",再反推"我需要多少显存",最后决定"是买显卡、还是换 Mac、还是就用 CPU 凑合"。
3. CPU 推理、Mac 统一内存、Windows 显卡:三条路线的注意事项
| 路线 | 适合谁 | 注意事项 |
|---|---|---|
| CPU 推理(llama.cpp) | 没独显、想在笔记本上凑合跑 3B–7B | 速度慢,但能跑;量化选对档位比什么都重要 |
| Apple Silicon(Mac 统一内存) | 内存 32GB+ 的 Mac 用户 | 统一内存可以当显存用,大内存是核心优势;选 MLX 或 llama.cpp 的 Metal 后端 |
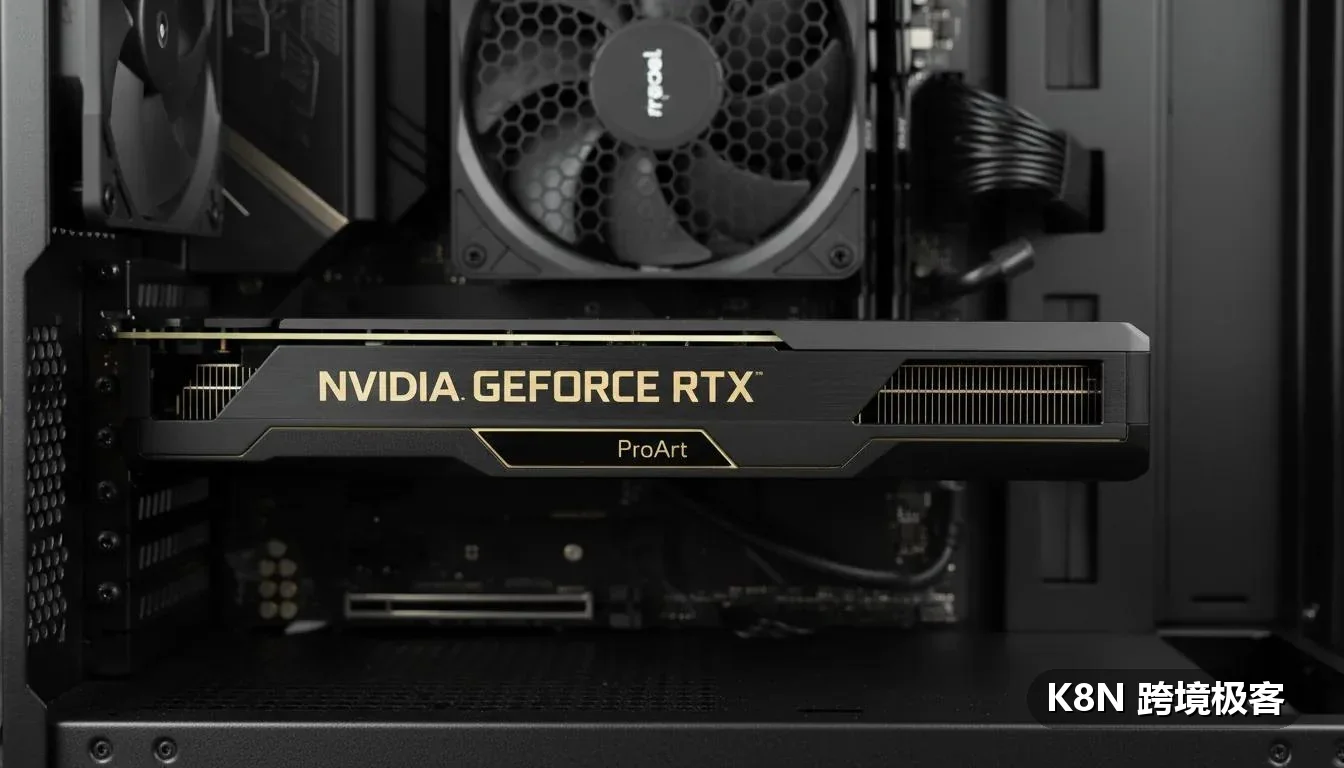
| NVIDIA 独显(Windows) | 有 8GB+ 显存的游戏卡 | CUDA 生态最完整,Ollama/llama.cpp/vLLM 都吃得开;注意驱动和 CUDA 版本对齐 |
两条经常被踩的坑:一是Mac 上 8GB 内存和 Windows 上 8GB 显存不是一回事——Mac 的统一内存要和系统共享,实际能分给模型的没有标称那么多;二是Windows 上 AMD 卡虽然 llama.cpp 已经支持 HIP,但生态远不如 NVIDIA 顺,新手不建议一上来碰。
 AI 操作示意图·以官网实际界面为准
4. 从"想跑多大模型"反推硬件的四步
- 先定场景:是"自己聊天玩玩",还是"要给应用当 API"?前者本地 Ollama 就够,后者要上 vLLM。
- 再定模型档位:7B/14B/32B/70B——日常写代码、问答、翻译,7B–14B 已经能应付大多数场景;70B 基本是"想接近云端旗舰"的人才需要。
- 按上面的粗算思路估显存,然后看自己机器能给多少。
- 能凑合就先凑合:在现有硬件上跑通 4-bit 量化的小模型,比"先买一张新卡再说"理性得多。本地推理是个越用越知道自己需求的过程,别一步到位。
最后一句实话:本地大模型这个赛道硬件支持每周都在扩,今天跑不动的模型,下个量化版本可能就跑得了了。别为"现在跑不动"焦虑,先把小的跑通再说。
官方资料
资料核对日期:2026-10-25。以下链接为各项目官方页面,具体支持的硬件、量化档位、模型列表以页面当前显示为准。
- llama.cpp 官方 GitHub 仓库:https://github.com/ggml-org/llama.cpp
- LM Studio 官网:https://lmstudio.ai/
- vLLM 官方文档:https://docs.vllm.ai/
最近一周热门文章
按近 7 天访问热度排序,热度积累前优先展示新文章。






当前栏目最新文章
AI 推荐 · 继续阅读同栏目的新内容
一起交流
0 条留言LEAVE A NOTE
你的经验,也很重要。
无需注册或登录。请勿公开邮箱密码、证件、银行卡号或其他敏感信息。





还没有留言,来分享你的想法吧。